Bir yapay zekâ asistanını kendi altyapınızda çalıştırmak istediğinizde ilk karar yalnızca hangi modeli kullanacağınız değildir. Modelin bellek ihtiyacını, kullanıcıların bekleyeceği yanıt süresini ve uygulamanın diğer parçalarını da düşünmeniz gerekir. AI VDS, GPU kaynağıyla birlikte sanal sunucu ortamı sunarak kendi modelinizi barındırmanıza imkân veren bir hizmettir. Hazır bir modelle sohbet etmek, metinleri özetlemek veya uygulamanıza yapay zekâ eklemek için değerlendirilebilir.
Bu rehberde AI VDS ile neler yapılabileceğini, VRAM ile RAM arasındaki farkı ve model seçiminin neden paket seçiminden önce geldiğini ele alıyoruz. Hedef Hosting’in AI VDS sunucu hizmetindeki model seçimi, otomatik kurulum ve Hedef AI sohbet paneli üzerinden başlangıç sürecini de açıklıyoruz.
AI VDS nedir, standart VDS’den farkı nedir?
AI VDS, yapay zekâ iş yüklerinde kullanılmak üzere GPU erişimi sunan sanal sunucudur. İşlemci, sistem belleği, depolama ve işletim sistemi katmanlarının yanında GPU’nun hesaplama gücü ve video belleği de kaynak planına girer. VDS sunucuda olduğu gibi uygulama ortamınızı yönetebilir, gerekli servisleri kurabilir ve erişim kurallarınızı belirleyebilirsiniz.
Standart bir VDS üzerinde bazı dil modelleri CPU ile çalışabilir. GPU desteği ise uyumlu modellerin belirli hesaplamalarını hızlandırmak için kullanılır. Elde edilecek sonuç; GPU mimarisine, modelin boyutuna, kullanılan çıkarım motoruna ve yapılandırmaya bağlıdır. Bir paketin adında “AI” bulunması, bütün modelleri veya yapay zekâ yazılımlarını aynı performansla çalıştıracağı anlamına gelmez.
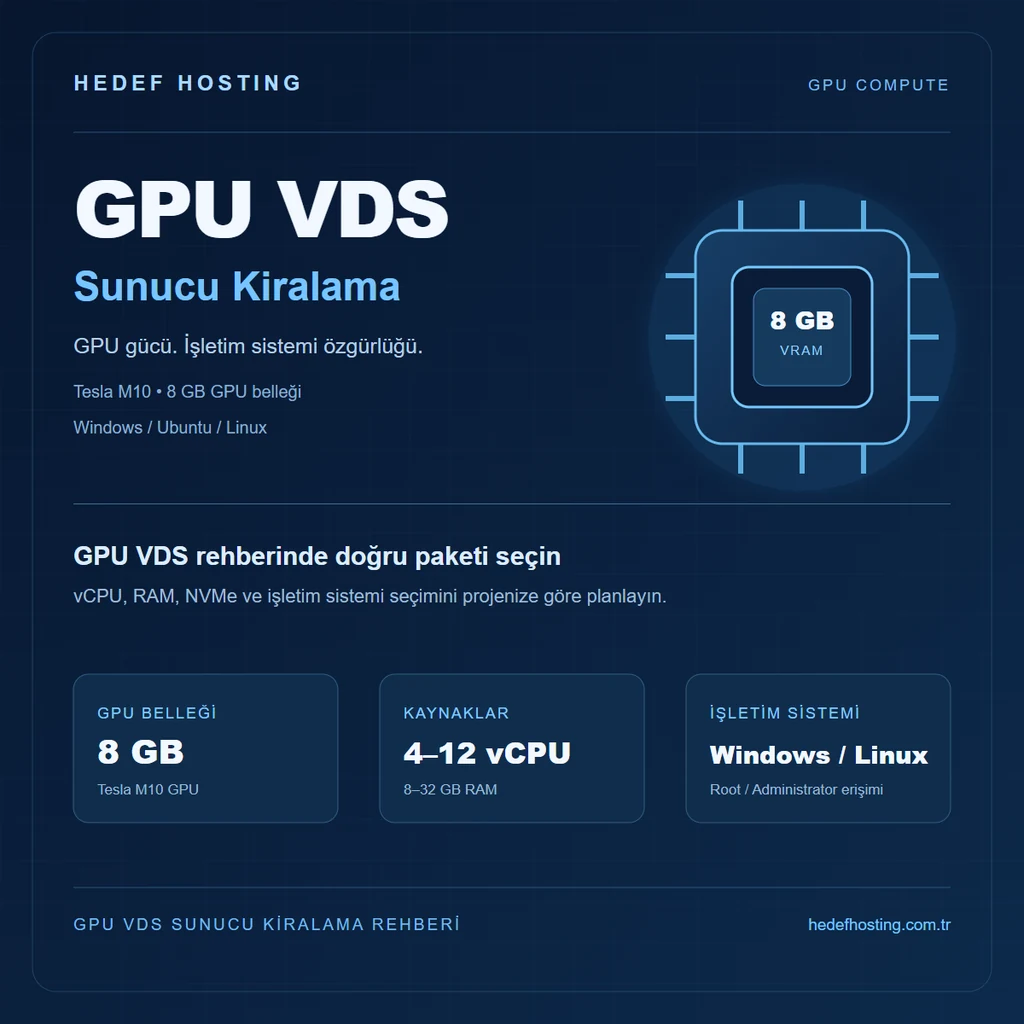
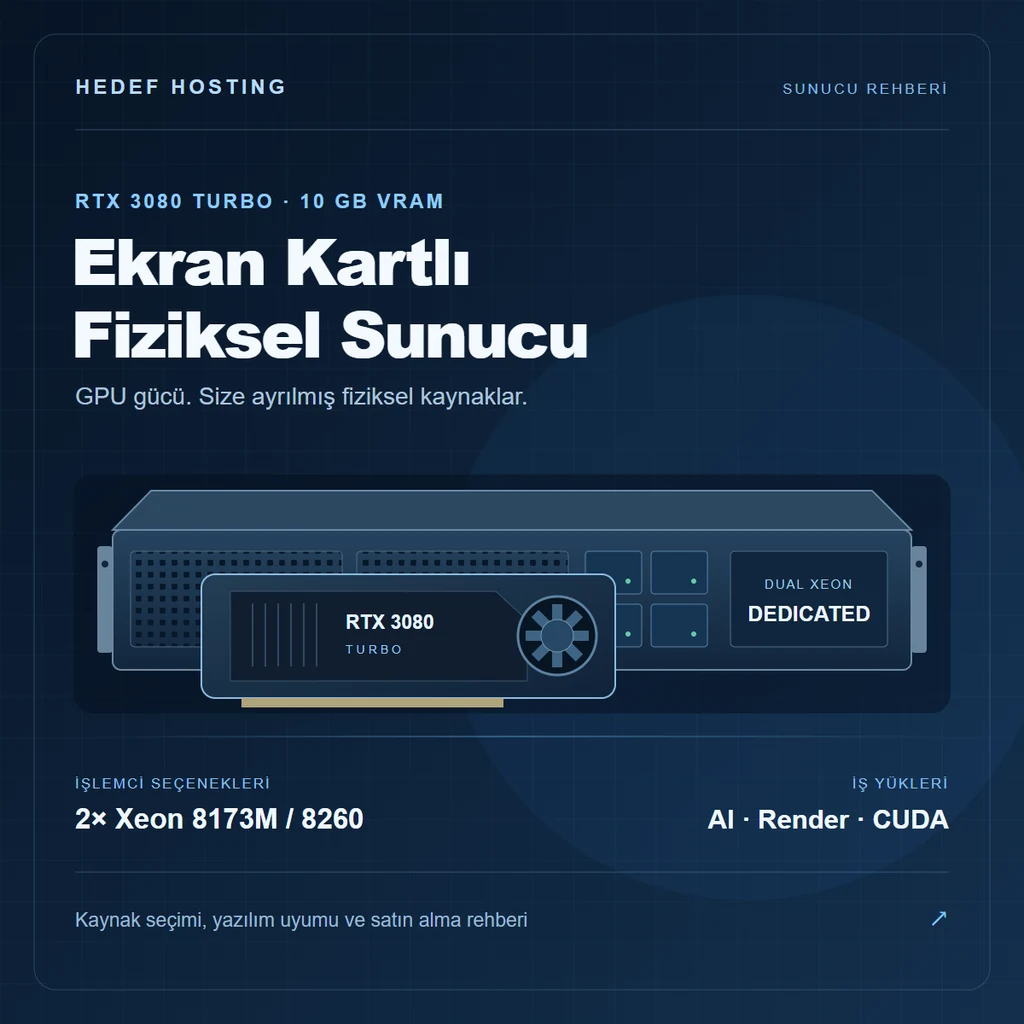
GPU hizmetlerini daha genel olarak karşılaştırmak isterseniz GPU VDS ve GPU sunucu kiralama rehberini okuyabilirsiniz. Buradaki odak, dil modeliyle çalışan bir uygulamanın ilk kurulumundan kullanılabilir hâle gelmesine kadar ihtiyaç duyduğu kaynaklardır.
Hazır yapay zekâ API’si mi, kendi sunucunuz mu?
Hazır bir API kullanmak, model sunucusunu yönetmeden uygulama geliştirmeyi kolaylaştırır. Kendi modelinizi barındırmak ise model dosyası, çalışma ayarları, uygulama bağlantıları ve erişim politikaları üzerinde daha fazla kontrol sağlar. Tercihi yalnızca aylık sunucu ücretine bakarak yapmak eksik bir karşılaştırma olur.
| Karar noktası | Hazır model API’si | AI VDS üzerinde model |
|---|---|---|
| Model seçimi | Sağlayıcının sunduğu modeller ve sürümler kullanılır. | Donanım, yazılım ve lisans koşullarına uygun model seçilir. |
| Başlangıç | API anahtarı ve uygulama entegrasyonu gerekir. | Model, çalışma ortamı ve erişim ayarları hazırlanır; desteklenen kurulumlar otomatikleştirilebilir. |
| Maliyet | Kullanım miktarı ve sağlayıcının fiyatlandırması belirleyicidir. | Sunucu ücretine yönetim, yedekleme ve varsa ek hizmetlerin maliyeti eklenir. |
| Kapasite | Servisin kota ve hız sınırları geçerlidir. | Modelin kaynak tüketimi ve sunucunun kapasitesi belirleyicidir. |
| Veri akışı | İsteklerin hangi hizmetlere gönderildiği incelenmelidir. | Yerel çıkarım mümkün olur; ek API’ler, kayıtlar ve yedekler ayrıca değerlendirilir. |
Düşük ve düzensiz kullanımda hazır API uygun olabilir. Modeli özelleştirmek, belirli bir sürümde kalmak veya kendi uygulama ortamınızı yönetmek istediğinizde AI VDS daha anlamlı bir seçenek hâline gelir. Kendi sunucunuzu kullanmak tek başına daha düşük maliyet, daha yüksek hız veya mevzuata uyum garantisi vermez; bu sonuçlar uygulamanızın tasarımına bağlıdır.
GPU VRAM, sistem RAM’i ve NVMe neden ayrı değerlendirilir?
Sunucu paketindeki bellek rakamlarını toplamak doğru bir kapasite hesabı değildir. GPU VRAM, modelin GPU’ya yerleştirilen ağırlıkları ve hesaplama sırasında kullanılan veriler için ayrılır. Sistem RAM’i, işletim sistemi, uygulama, veri işleme ve CPU tarafındaki model işlemlerine alan sağlar. NVMe SSD ise model dosyalarını, belgeleri, arama indeksini ve uygulama kayıtlarını saklar.
Örneğin 8 GB GPU VRAM ve 32 GB sistem RAM’i olan bir sunucu, 40 GB VRAM’li bir GPU gibi davranmaz. Bazı çalışma motorları modelin bir bölümünü CPU’da, bir bölümünü GPU’da çalıştırabilir. Bu yaklaşım daha büyük bir modeli yüklemeyi mümkün kılabilse de işlemciye taşınan yük yanıt süresini etkileyebilir.
Hedef Hosting’in mevcut AI VDS paketlerinde NVIDIA Tesla M10 üzerinde 8 GB GPU belleği sunulur. Paketler arasında vCPU, sistem RAM’i ve NVMe kapasitesi değişir. Daha yüksek pakete geçmek uygulama servislerine alan açar; GPU belleğini artırmaz. GPU uyumluluğu için sürücü, CUDA ve çıkarım motorunun sürümü de birlikte kontrol edilmelidir.
8 GB VRAM için dil modeli nasıl seçilir?
Modelin adındaki “3B”, “7B” veya “8B”, yaklaşık parametre sayısını ifade eder. Parametre sayısı bir başlangıç göstergesidir; belleğe sığma kararını tek başına verdirmez. Aynı modelin farklı hassasiyetlerdeki dosyaları, farklı bağlam ayarları ve farklı motorlarla çalışırken kaynak tüketimi değişebilir.
Quantization: model ağırlıklarını daha az yerle saklamak
Quantization, model ağırlıklarının daha düşük sayısal hassasiyetle temsil edilmesidir. Böylece ağırlıkların kapladığı alan azalabilir; çıktı kalitesi üzerindeki etkisi model ve görevle birlikte değerlendirilir. GGUF ise llama.cpp gibi araçların kullandığı model dosyası biçimidir. Bir dosyanın GGUF olması, boyutundan bağımsız şekilde her GPU’da çalışacağı anlamına gelmez.
Basitleştirilmiş bir hesapta 7 milyar parametrenin her birini 4 bit ile temsil etmek yaklaşık 3,5 GB ham ağırlık verisi eder. Bu, tam çalışma belleği ihtiyacı değildir. Quantization ek verileri, diğer tensörler, hesaplama tamponları ve bağlam için tutulan önbellek toplam kullanımı yükseltir. Dolayısıyla “dosya 4 GB, GPU 8 GB; kesin yeter” şeklinde karar verilmemelidir.
Bağlam uzunluğu ve eşzamanlı kullanım
Bağlam, modelin bir yanıt üretirken dikkate aldığı konuşma ve diğer metinlerin bütünüdür. Uzun bir sohbet geçmişi veya büyük bir belge eklemek, özellikle KV cache olarak bilinen çalışma önbelleğinin bellek ihtiyacını artırabilir. Aynı anda birden fazla istek işlendiğinde bellek kullanımı ve kuyruk bekleme süresi de değişir.
Başlangıçta görevini iyi yapan küçük bir model seçin. Türkçe yanıt kalitesini, yönergeye uyumunu ve kullandığınız belge türleriyle başarısını deneyin. Daha büyük modele geçişi yalnızca parametre sayısına göre değil, aynı örnek sorular üzerinde ölçtüğünüz sonuçlara göre değerlendirin.
Hangi yapay zekâ modelleriyle başlanabilir?
Hedef Hosting AI VDS model kataloğunda Qwen, DeepSeek, Phi, SmolLM, Granite, Mistral tabanlı modeller, TinyLlama ve OLMoE gibi ailelerden seçenekler bulunur. Siparişte sunulan modeller, seçilen paketin RAM ve disk koşullarına göre filtrelenir. Güncel aileleri ve kurulum kapsamını desteklenen AI modelleri bölümünde inceleyebilirsiniz.
Bir model ailesinin adı, o ailenin bütün sürümlerinin desteklendiği anlamına gelmez. Örneğin katalogdaki küçük bir DeepSeek türevi ile çok daha büyük bir DeepSeek sürümü aynı donanım gereksinimine sahip değildir. Seçimde tam model adı, dosya sürümü, quantization biçimi ve model kartındaki kullanım koşulları esas alınmalıdır.
Sohbet için yönerge takibi güçlü bir instruct modeli; kod yardımı için ilgili görevlerde denenmiş bir model düşünülebilir. Belge asistanında ise yanıt kalitesi kadar kaynak metne bağlı kalma davranışı önemlidir. Model lisansının ticari kullanım ve dağıtım koşullarını da kontrol edin; indirilebilir olması sınırsız kullanım hakkı anlamına gelmez.
AI VDS ile kendi yapay zekâ asistanınızı başlatma adımları
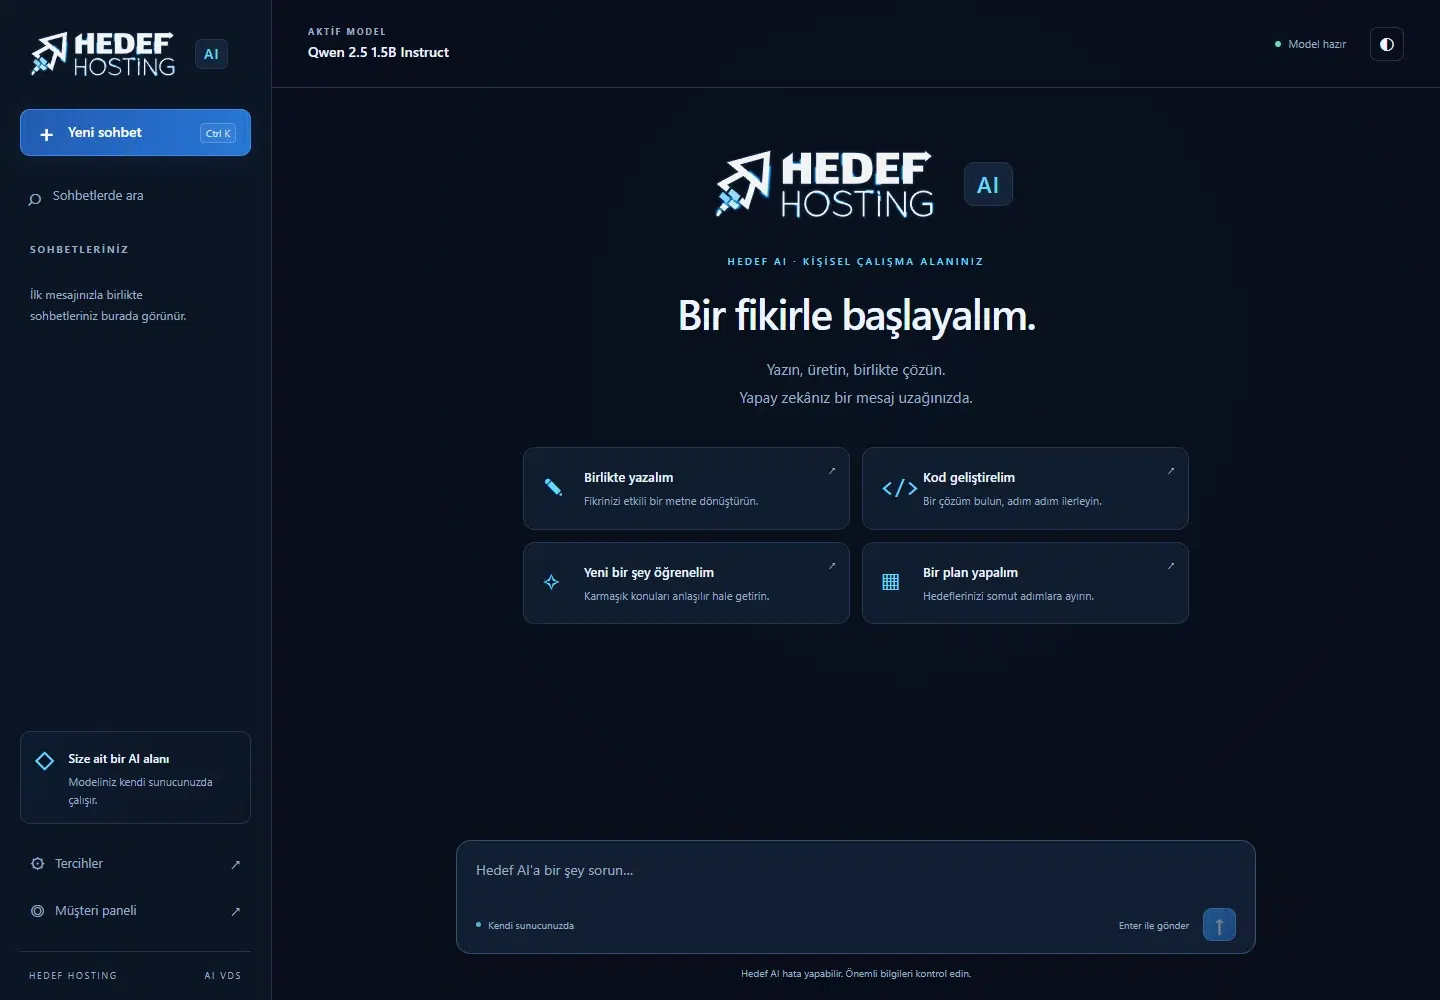
Hedef Hosting’in otomatik kurulum akışı, katalogdan seçilen model ve Hedef AI sohbet paneliyle başlangıcı kolaylaştırır. Uygulamaya özel entegrasyon ihtiyaçlarını ise bu temel kurulumun üzerine planlayabilirsiniz.
- Asistanın görevini belirleyin. Genel sohbet, kısa metin özetleme, kod yardımı veya belge üzerinden yanıt verme farklı ihtiyaçlar doğurur. Beklenen Türkçe içerik kalitesini ve yanıt uzunluğunu yazın.
- Paketi ve uygun katalog modelini seçin. Modelin yanında çalışacak API, veri tabanı ve arama indeksinin kaynaklarını da hesaba katın. Sipariş ekranında pakete uygun seçenekleri değerlendirin.
- Otomatik kurulumun tamamlanmasını bekleyin. Sipariş ve ödeme sonrasında Ubuntu 22.04 LTS, llama.cpp çalışma ortamı, seçilen GGUF modeli ve Hedef AI paneli kurulum akışına alınır. Süre, model indirme ve sunucu hazırlığı gibi adımlara bağlıdır.
- Müşteri alanından paneli açın. Kurulum kontrolleri tamamlandığında hizmet detaylarında HTTPS panel adresi ve hizmete özel giriş bilgileri görünür. Hedef AI panelini bu bilgilerle kullanabilirsiniz.
- Gerçek sorularla ilk denemeyi yapın. Modelin yalnızca açılmasını değil, işinizde karşılaşacağı sorulara verdiği cevapları değerlendirin. Yanıt uzunluğu ve bağlam ihtiyacını buna göre ayarlayın.
- Entegrasyonu ve işletimi planlayın. Web sitenize ekleme, kurum içi oturum açma veya özel iş akışı gibi talepler, temel sohbet panelinden ayrı bir uygulama çalışması gerektirebilir.
Hedef AI’nin Türkçe sohbet arayüzünde kod yanıtlarını kopyalayabilir, yanıt uzunluğu ve tema seçeneklerini kullanabilirsiniz. Sohbet geçmişi kullanılan tarayıcıda tutulur; cihazlar arasında otomatik eşitlenmez. Tarayıcı verilerinin silinmesini de dikkate alarak önemli içeriklerinizi ayrıca saklayın.
RAG, sohbet asistanı ve API projelerinde kaynak planı
Bir sohbet paneli, dil modeliyle etkileşimin başlangıç noktasıdır. Kendi belgelerinizden yanıt üreten veya başka uygulamalarla konuşan bir sistem için ek bileşenler gerekir. Aynı sunucuda barındıracağınız her bileşenin kaynak tüketimini birlikte düşünmelisiniz.
| Proje | Model dışında gerekenler | Ölçülecek sonuç |
|---|---|---|
| Özel sohbet asistanı | Kullanıcı erişimi, sohbet arayüzü ve uygun sistem talimatları | Yanıt doğruluğu, ilk yanıt gecikmesi ve konuşma uzadıkça kaynak kullanımı |
| Doküman asistanı / RAG | Belge ayrıştırma, embedding modeli, arama indeksi ve erişim denetimi | Doğru kaynağın bulunması, kaynağa bağlı yanıt ve indeksleme süresi |
| Metin işleme API’si | Kimlik doğrulama, istek kuyruğu, hız sınırı ve hata yönetimi | Eşzamanlı isteklerde yanıt süresi, hata oranı ve bellek tüketimi |
RAG, belgeleri modelin ağırlıklarına yeniden öğretmekle aynı işlem değildir. Önce soru için ilgili metin parçaları bulunur, ardından bu parçalar modelin bağlamına eklenir. Belge sayısı, indeks yöntemi ve embedding modeli sistem RAM’i ile disk ihtiyacını etkiler. GPU’yu embedding işlemi için de kullanacaksanız bu yükün sohbet modeliyle çakışmasını hesaba katın.
Örneğin şirket içi bir bilgi asistanını önce küçük ve güncel bir doküman kümesiyle deneyebilirsiniz. Yanıtların hangi kaynağa dayandığını kontrol edin, ilgisiz sorularda davranışını ölçün ve ancak sonra kapsamı büyütün. Model kataloğundan seçim yapmak tek başına belge yükleme, vektör veri tabanı veya kullanıcı bazında belge yetkilendirmesi kurmaz.
Hangi AI VDS paketi projenize daha uygun?
Paket kararını iki ayrı soruya bölün: Model için ayrılan GPU belleği ve yazılım uyumu yeterli mi; uygulamanın geri kalanı için CPU, RAM ve disk yeterli mi? İlk sorunun yanıtı olumsuzsa yalnızca sistem RAM’ini artırmak çözüm olmayabilir.
Mini ve Start gibi daha düşük sistem kaynaklarına sahip seçenekler, uygun küçük modellerle ilk denemeler için değerlendirilebilir. Uygulama servisi, belge indeksi ve veri tabanı aynı sunucuda büyüdükçe Plus, Pro veya Max seçeneklerindeki ek sistem kaynakları faydalı olabilir. Ancak bunlar kullanıcı sayısı ya da saniyedeki üretilen token miktarı için hazır bir kapasite garantisi değildir.
Güncel kaynakları ve ödeme seçeneklerini AI VDS paketleri ve fiyatları bölümünden karşılaştırın. Yazının içindeki sabit bir fiyat yerine ürün sayfasına bakmak, sipariş sırasında geçerli olan tutarı ve kapsamı görmenizi sağlar. GPU kullanmayan servisler için standart VDS sunucu seçenekleri de ayrıca değerlendirilebilir.
Satın almadan önce küçük bir değerlendirme planı hazırlayın
Model seçimini somutlaştırmak için 10–20 gerçek örnek soru veya görevden oluşan bir deneme listesi hazırlayabilirsiniz. Kısa ve uzun metinleri, Türkçe içerikleri ve modelin cevap vermemesi gereken durumları bu listeye ekleyin. Bu sayı bir performans ölçütü değil, ilk karşılaştırmayı düzenlemek için pratik bir başlangıçtır.
- Kalite: Yanıt doğru mu, istenen biçimde mi ve verilen kaynakla tutarlı mı?
- Gecikme: İlk çıktı ne kadar sürede geliyor, yanıtın tamamlanması ne kadar sürüyor?
- Yük: Aynı anda birkaç istek geldiğinde kuyruk ve hata durumu nasıl değişiyor?
- Kaynak: Seçilen bağlam uzunluğunda VRAM ve sistem RAM’i için yeterli boşluk kalıyor mu?
- İşletim: Güncelleme, erişim yönetimi, kayıtlar ve yedeklemeyi kim takip edecek?
Aynı testleri aynı model sürümü ve ayarlarla tekrar ederek karar verin. Kullanıcı deneyiminin sınırını gördükten sonra bağlamı kısaltmak, yanıt uzunluğunu azaltmak, daha küçük model seçmek veya ek kaynak planlamak daha kolay olur.
AI VDS hakkında sık sorulan sorular
AI VDS almak, ücretli bir sohbet uygulamasının aboneliğini sağlar mı?
AI VDS, sunucu ve belirtilen kurulum kapsamını sağlar. Başka bir şirketin sohbet ürünü veya ücretli model API aboneliği otomatik olarak pakete dahil olmaz. Katalog modeliyle sunulan paneli, üçüncü taraf servislerin üyeliklerinden ayrı değerlendirin.
Her açık model ticari projede kullanılabilir mi?
Bu, modelin lisansına bağlıdır. Aynı ailenin farklı sürümlerinde bile kullanım şartları değişebilir. Ticari kullanım, yeniden dağıtım ve gerekiyorsa atıf şartlarını seçtiğiniz modelin kendi model kartından kontrol edin.
Kendi sunucumda model çalıştırırsam verilerim tamamen içeride mi kalır?
Çıkarım sunucuda yerel olarak yapılabilir. Bununla birlikte harici embedding servisi, üçüncü taraf API, günlük toplama veya dış yedekleme kullanırsanız bazı veriler bu hizmetlere gidebilir. Veri akışını, uygulamanın bütün bileşenleri üzerinden değerlendirin.
Hazır modeli kullanmak ile model eğitmek aynı şey mi?
Hazır modelden yanıt üretmeye çıkarım denir. Eğitim ve ince ayar, model ağırlıklarını değiştiren ayrı işlemlerdir ve farklı kaynak ihtiyaçları vardır. Buradaki seçim yaklaşımı hazır modellerin çıkarımına odaklanır; eğitim planı ayrıca donanım ve yazılım gereksinimleriyle ele alınmalıdır.
Projeniz için model ve sunucuyu birlikte seçin
İyi bir başlangıç, en büyük modeli seçmekten önce işinizi tanımlamakla mümkün olur. Doğru yanıt veren bir model, yeterli bağlam kapasitesi ve sürdürülebilir bir uygulama ortamı birlikte planlandığında AI VDS daha kullanışlı hâle gelir.
Hedef Hosting AI VDS sayfasından model seçeneklerini, Hedef AI panelini ve paket kaynaklarını inceleyebilirsiniz. Kullanmak istediğiniz modelin tam adı, örnek görevleriniz ve beklenen eşzamanlı kullanım bilgisiyle teknik ekiple görüşerek projenize uygun başlangıcı değerlendirebilirsiniz.
Teknik başvuru: llama.cpp resmî deposu ve GGUF dosya biçimi belgesi. Model, paket ve panel özellikleri zamanla değişebilir; sipariş sırasında güncel ürün sayfasındaki kapsam esas alınmalıdır.
Konuyu farklı yönleriyle ele alan diğer rehberlere göz atın.